Jede Antwort eines Webservers beginnt mit einer dreistelligen Zahl. Sie entscheidet, ob ein Besucher die Seite sieht und ob Google sie im Index behält. Wer die wichtigsten Codes kennt, findet kaputte Links schneller, kündigt Wartungsarbeiten richtig an und baut eine Fehlerseite, die Besucher auf der Website hält, statt sie mit einer englischen Standardmeldung allein zu lassen.
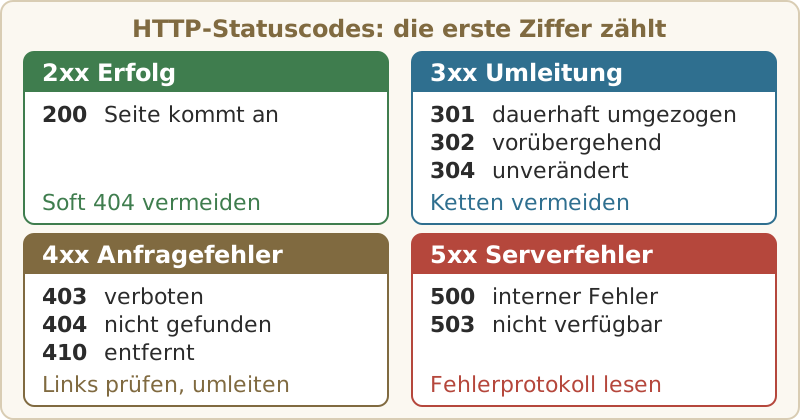
HTTP-Statuscodes bekommst du selten zu sehen, obwohl jede Antwort des Servers einen enthält. Du findest sie in den Entwicklerwerkzeugen des Browsers (F12, Reiter Netzwerk), im Zugriffsprotokoll des Servers und in der Google Search Console. Die erste Ziffer sagt dir, wo du suchen musst: 2 steht für Erfolg, 3 für eine Umleitung, 4 für ein Problem mit der angefragten Adresse und 5 für einen Fehler im Server selbst. Alle Codes von 100 bis 505 auf einen Blick zeigt die Liste der HTTP-Fehlercodes.
Die HTTP-Statuscodes, die dir wirklich begegnen
| Code | Bedeutung | Für Besucher | Für Google |
|---|
| 200 OK | Anfrage erfüllt | sieht die Seite | kann die Seite indexieren |
| 301 Moved Permanently | dauerhaft umgezogen | landet auf der neuen Adresse | übernimmt die neue Adresse |
| 302 Found | vorübergehend woanders | landet auf dem Ziel | behält meist die alte Adresse |
| 304 Not Modified | seit dem letzten Abruf unverändert | bekommt die Kopie aus dem Browser-Cache | wertet den Inhalt als unverändert |
| 403 Forbidden | Zugriff verweigert | sieht eine Fehlermeldung | behandelt die Adresse wie eine 404 |
| 404 Not Found | Adresse gibt es nicht | sieht die Fehlerseite | nimmt die Adresse aus dem Index und fragt seltener nach |
| 410 Gone | absichtlich entfernt | sieht die Fehlerseite | wie 404 |
| 500 Internal Server Error | Fehler im Server | sieht eine leere oder allgemeine Fehlerseite | crawlt langsamer, entfernt die Adresse, wenn der Fehler bleibt |
| 503 Service Unavailable | vorübergehend nicht verfügbar | sieht die Wartungsseite | crawlt langsamer, behält die Seite vorerst im Index |
Eine 304 ist kein Fehler. Der Browser fragt, ob sich eine Datei seit dem letzten Besuch geändert hat, und der Server antwortet mit „nein“, ganz ohne Inhalt. Wie du den Browser-Cache gezielt einstellst, zeigt der Artikel Ladezeit der Website verbessern.
Eine 403 kommt oft von fehlenden Leserechten oder von einem Ordner ohne Startdatei, dessen Inhaltsverzeichnis der Server nicht anzeigen darf. Dieses Verbot ist gewollt, mehr dazu im Artikel Website absichern. Hinter einer 500 steckt oft ein Tippfehler in der .htaccess oder ein abgebrochenes PHP-Skript.
404 oder 410?
Beide sagen: Hier ist nichts. Eine 410 sagt zusätzlich, dass die Seite absichtlich und dauerhaft entfernt wurde. Google behandelt nach eigener Aussage alle 4xx-Codes außer 429 gleich, die Adresse verschwindet in beiden Fällen aus dem Index. Bestehende 404 auf 410 umzubauen bringt bei Google also wenig. Löschst du eine Seite bewusst, ist 410 trotzdem die genauere Antwort, und in der .htaccess kostet sie eine Zeile:
Redirect gone /alte-aktion.html
Gibt es einen Nachfolger mit ähnlichem Inhalt, ist eine Weiterleitung besser als jeder Fehlercode. Den Code dafür findest du im Artikel 301-Weiterleitung mit .htaccess einrichten. Sperre gelöschte Adressen nicht in der robots.txt, sonst ruft Google sie nicht mehr ab und bekommt die 404 nie zu sehen. Aus der Sitemap nimmst du sie dagegen heraus. Wie beide Dateien zusammenspielen, erklärt der Artikel über robots.txt und XML-Sitemap.
Weiche 404-Fehler
Eine weiche 404 (englisch Soft 404) ist eine Seite, die „nicht gefunden“ sagt, aber mit 200 antwortet. Google erkennt solche Seiten am Inhalt und meldet sie in der Search Console. Typische Ursachen:
- Ein PHP-Skript zeigt bei einer unbekannten ID eine Fehlermeldung, sendet aber keinen Fehlercode.
- Alle fehlenden Seiten werden auf die Startseite umgeleitet.
- Kategorie- oder Suchseiten bleiben leer und haben keinen eigenen Inhalt.
Im PHP-Skript reicht eine Zeile vor der ersten Ausgabe: http_response_code(404);. Die Umleitung auf die Startseite wirkt bequem. Google kann sie aber ebenfalls als weiche 404 werten, und der Besucher findet trotzdem nicht, was er gesucht hat.
503 bei Wartungsarbeiten
Baust du die Website um, soll Google weder die halbfertige Seite noch eine Baustellenmeldung mit Status 200 speichern. Eine 503 sagt: gleich wieder da. Google crawlt dann langsamer und behält die Seiten vorerst im Index. Dauert der Zustand lange, verschwinden sie nach und nach. Du brauchst zwei Dateien. Die .htaccess schickt alle Besucher außer dir auf die Wartungsseite. Diese Zeilen gehören ganz nach oben, vor die Regeln deines CMS:
RewriteEngine On
RewriteCond %{REMOTE_ADDR} !^203\.0\.113\.5$
RewriteCond %{REQUEST_URI} !^/wartung\.php$
RewriteRule ^ /wartung.php [L]
Statt 203.0.113.5 trägst du deine eigene IP-Adresse ein, und zwar so, wie sie im Zugriffsprotokoll des Servers steht. Die Datei wartung.php sendet den Status und mit Retry-After die voraussichtliche Wartezeit in Sekunden:
<?php
http_response_code(503);
header('Retry-After: 3600');
?>
<p>Wir bauen um. In etwa einer Stunde sind wir zurück.</p>
Die Regel fängt auch Bilder und Stylesheets ab. Halte die Wartungsseite deshalb schlicht, ohne eingebundene Dateien, und entferne die Regel, sobald die Arbeiten fertig sind.
Eine eigene Fehlerseite einrichten
Die Standardmeldung von Apache ist ein englischer Satz ohne Menü und ohne Weg zurück. Eine eigene Seite trägst du mit ErrorDocument in die .htaccess ein:
ErrorDocument 404 /fehler/404.html
ErrorDocument 410 /fehler/410.html
Zwei Fehler passieren dabei leicht:
- Eine vollständige Adresse mit
https:// statt eines Pfads. Apache leitet dann auf die Fehlerseite um, und Browser wie Google bekommen statt der 404 eine Weiterleitung.
- Relative Pfade zu Stylesheet und Bildern. Die Fehlerseite erscheint unter jeder beliebigen Adresse, auch tief in Unterordnern, und dort zeigt
style.css ins Leere. Schreib die Pfade ab dem Hauptverzeichnis, also /style.css.
Ruf danach mit curl -I eine erfundene Adresse auf. In der Statuszeile muss 404 stehen, nicht 200 und keine 302.
Was auf eine gute 404-Seite gehört
- Ein klarer Satz in normalen Worten, dass es unter dieser Adresse nichts gibt.
- Kopf, Menü und Gestaltung deiner Website, damit der Besucher sieht, dass er noch richtig ist.
- Ein Suchfeld und Verweise auf die Startseite und die wichtigsten Bereiche.
- Ein Weg, den kaputten Link zu melden, etwa per E-Mail oder Kontaktformular.
Lass die Seite nicht nach ein paar Sekunden automatisch auf die Startseite springen. Der Besucher hat dann kaum Zeit zu lesen, was passiert ist, und muss dort von vorn suchen.
Fehler in den Protokollen des Servers finden
Apache schreibt jeden Aufruf ins Zugriffsprotokoll (access log) und Fehlermeldungen ins Fehlerprotokoll (error log). Auf eigenen Linux-Servern liegen beide meist unter /var/log/apache2/ oder /var/log/httpd/. Bei Hosting-Paketen findest du sie im Kundenmenü des Anbieters. Eine Zeile im Zugriffsprotokoll sieht so aus:
203.0.113.7 - - [16/Nov/2026:10:12:01 +0100] "GET /alt.html HTTP/1.1" 404 1243 "https://www.example.de/links.html" "Mozilla/5.0 ..."
Nach der Anfrage folgen der Statuscode, die Größe der Antwort, die Seite mit dem Link und der Browser. Welche Adressen am häufigsten mit 404 enden, zeigt dieser Befehl:
awk '$9 == 404 {print $7}' access.log |
  sort | uniq -c | sort -rn | head
Steht oben eine Adresse, die es früher gab, lohnt sich eine Weiterleitung. Mit $11 statt $7 listet derselbe Befehl die Seiten, auf denen die kaputten Links stehen, in Anführungszeichen. Ein "-" heißt, dass der Browser keine solche Seite mitgeschickt hat. Sind eigene Seiten darunter, korrigierst du die Links dort. Aufrufe von Bots, die nach bekannten Sicherheitslücken suchen, kannst du ignorieren.
Bei einer 500 schaust du ins Fehlerprotokoll. Dort steht meist der Grund, zum Beispiel Invalid command bei einem Tippfehler in der .htaccess oder die Meldung eines PHP-Skripts mit Datei und Zeilennummer. Fragen rund um Google und den Index beantwortet die FAQ zu Suchmaschinen.
Weiterlesen


